Claude Opus 5.5 effort 레벨 비교: low부터 max까지 같은 과제로 본 비용과 품질
Claude Opus 5.5에 뮤직비디오와 3D 강남역 탐험 과제를 주고 effort 레벨만 low부터 max까지 바꿔 돌렸습니다. 단계별 API 환산 비용, 결과물 차이, 블라인드 평가, 선택 기준과 설정 방법을 정리했습니다.
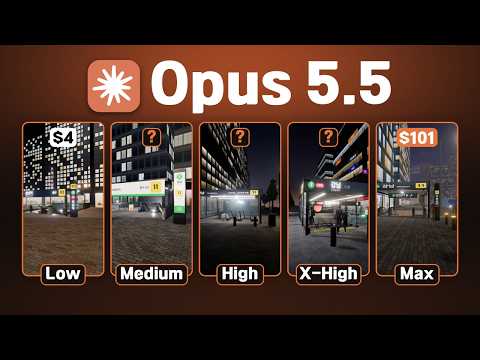
여러분, Claude Opus 5.5를 쓰면서 effort 레벨을 어디에 둬야 할지 고민해보신 적 있으실 겁니다. 결론부터 말하면, 기능 구현만 필요하면 low나 medium으로 충분하고, 가성비는 high, 품질이 최우선이면 max입니다. 가장 애매한 단계는 xhigh였습니다.
직접 돌려보고 내린 결론입니다. 같은 Opus 5.5에게 같은 과제 두 개를 주고, effort만 low, medium, high, xhigh, max 다섯 단계로 바꿔 결과물과 비용을 비교했습니다. 품질만 보면 max가 두 과제 모두 1위였지만, 비용은 xhigh에서 max로 넘어가는 구간에서 가장 크게 늘었습니다.
과제는 두 가지였습니다. 하나는 서울 지하철 2호선 노래에 맞춘 30초 뮤직비디오, 다른 하나는 강남역 출구에서 열차까지 걸어가는 1인칭 3D 탐험 시뮬레이션입니다. 둘 다 외부 에셋 없이 전부 코드로만 만들게 했습니다.
Claude Opus 5.5 effort 비교 핵심 요약
- Opus 5.5의 effort는 low, medium, high, xhigh, max 다섯 단계이고, API와 Claude Code 모두 따로 정하지 않으면 medium으로 실행됩니다.
- API 환산 비용은 뮤직비디오가 low 1.45달러에서 max 30.35달러, 강남역 탐험이 low 3.95달러에서 max 101.06달러였습니다.
- low도 기능 요구사항은 대부분 해냈습니다. 차이는 기능이 아니라 디테일과 연출의 밀도에서 났습니다.
- GPT-6 Astra에게 effort를 가린 채 블라인드 평가를 맡겼더니 두 과제 모두 max가 1위, low가 5위였습니다.
- 증가 금액은 xhigh에서 max로 갈 때 가장 컸고(뮤직비디오 +18.39달러, 강남역 +71.47달러), 점수 1점당 비용은 high를 넘어서면 약 9배에서 11배로 커졌습니다.
- 강남역 max는 도구 호출 571회(xhigh의 약 3.7배)에 서브 에이전트 2개를 띄워, 일하는 방식부터 달랐습니다.
- xhigh는 과제에 따라 2위와 4위를 오갔습니다. 단계마다 한 번씩 돌린 자체 벤치라 다시 돌리면 순위가 바뀔 수 있습니다.
Claude Opus 5.5의 effort는 무엇을 바꾸나
2026년 9월 22일에 나온 Opus 5.5는 써본 사람들 사이에서 “거의 토큰 무제한으로 쓰는 것 같다”는 말까지 나온 모델입니다. Anthropic 발표에 따르면 2026년 10월 3일 기준 입력·출력 토큰 단가는 100만 토큰당 4달러, 20달러로 Opus 5보다 20% 낮고, 기본 설정 기준으로 일반적인 작업에서 Opus 5보다 40% 적은 비용이 든다고 합니다. 이 40%는 아래에서 볼 기본 effort(medium)와 함께 봐야 하는 숫자입니다.
effort는 Claude가 한 번 일할 때 얼마나 공을 들일지 정하는 설정입니다. 올릴수록 비용과 시간이 더 들지만 디테일을 더 꼼꼼하게 챙깁니다. 다만 단순히 “생각을 얼마나 오래 하느냐”는 아닙니다. 공식 effort 문서는 effort가 답변 텍스트, 도구 호출과 인자, 생각(thinking)까지 응답의 모든 토큰에 영향을 준다고 설명합니다. effort를 낮추면 도구 호출도 더 적고 짧아지죠. 게다가 Opus 5.5는 adaptive thinking이 항상 켜져 있고 끌 수 없어서, effort가 추론량과 요청 비용을 조절하는 주된 수단입니다.
공식 문서의 다섯 단계 설명을 정리하면 이렇습니다.
| effort | 공식 설명 요약 | 문서가 제시하는 쓰임 |
|---|---|---|
| low | 가장 효율적. 토큰을 크게 아끼는 대신 성능이 조금 줄어듦 | 속도와 비용이 가장 중요한 단순 작업(예: 서브 에이전트) |
| medium | 토큰을 적당히 아끼는 균형형. Opus 5.5의 기본값 | 속도, 비용, 성능의 균형이 필요한 에이전트 작업 |
| high | 뛰어난 결과에 필요한 만큼 토큰을 씀. API 기준, effort를 지원하는 모델 중 Opus 5.5를 뺀 나머지의 기본값(Claude Code에서는 Sonnet 5.5도 medium) | 복잡한 추론, 어려운 코딩, 에이전트 작업 |
| xhigh | 장시간 작업용 확장 단계 | 30분 넘게 도는 에이전트·코딩 작업(토큰 예산 수백만 단위) |
| max | 토큰 사용에 제한을 두지 않는 최대 성능 | 가장 깊은 추론과 철저한 분석이 필요한 작업 |
제가 더 중요하게 보는 건 기본값입니다. Opus 5.5의 기본 effort는 medium이고, API든 Claude Code든 따로 정하지 않으면 medium으로 실행됩니다. Opus 5와 그 이전 Opus 모델은 high가 기본이었으니, 지정하지 않은 요청은 Opus 5 때보다 한 단계 낮게 도는 셈이죠. Anthropic은 자체 테스트에서 Opus 5.5의 medium이 코딩과 지식 작업 평가에서 Opus 5의 high와 같거나 더 나았다고 설명합니다. 그러면서도 이전 모델 설정을 그대로 가져오지 말고, 내 평가 과제로 effort를 단계별로 돌려보라(Run an effort sweep on your own evals)고 권합니다.
Opus 5에서 effort를 낮춰도 답변이 짧아지지 않는 이유와, thinking을 끄기보다 낮은 effort부터 검토하는 기준은 Claude Opus 5 프롬프트 가이드에서 정리했는데요. 이번에는 공식 문서 권고대로 Opus 5.5에서 다섯 단계를 실제 과제로 전부 돌려봤습니다.
실험 설계: 같은 과제 두 개를 low부터 max까지
규칙은 단순합니다. 같은 Opus 5.5, 같은 프롬프트, 바꾸는 건 effort 하나뿐입니다. 과제 두 개를 다섯 단계씩 총 열 번 돌렸고, 매번 새 세션에서 같은 설정으로 시작했습니다.
실행은 Claude Max 구독으로 했고, 비용은 세션 로그에 남는 API 환산 비용으로 비교했습니다. 같은 작업을 API로 실행했다면 나왔을 금액이라, 실제로 청구된 돈은 아닙니다.
과제 1: 2호선 테마송 30초 뮤직비디오
먼저 ElevenLabs로 서울 지하철 2호선을 노래한 30초짜리 곡 “순환선”을 만들어뒀습니다. 이 음악 파일과 가사 파일을 함께 넣고, 뮤직비디오를 처음부터 끝까지 혼자 만들어달라고 했습니다. 프롬프트 첫머리는 이렇습니다.
./input/song.mp3는 서울 지하철 2호선을 노래한 30초짜리 곡 "순환선"이고, ./input/lyrics.md에 가사가 있어.
이 곡의 뮤직비디오를 처음부터 끝까지 혼자 만들어줘. 중간에 나에게 묻지 말고 판단해서 진행해.
네가 얼마나 뛰어난 모션 디자이너인지 보여줘. 흔한 AI 영상 느낌은 피하고, 일관된 스타일 하나를 정해서 끝까지 밀어붙여.
그 아래 요구사항의 핵심은 외부 이미지·영상 생성 모델, 스톡 에셋, 외부 API를 전혀 쓰지 않고 오로지 코드로만 만드는 것이었습니다. 음악과 가사만 주고, 그림은 전부 모델이 코드로 그려야 합니다.
과제 2: 강남역 탐험 1인칭 3D 시뮬레이션
두 번째는 강남역 탐험 시뮬레이션입니다. 플레이어는 밤 9시 퇴근길 직장인이 되어 강남역 지상 출구로 내려가고, 대합실과 개찰구를 지나 2호선 승강장에서 열차를 타는 여정을 천천히 걸으며 둘러봅니다. 여기서도 3D 모델, 텍스처, 이미지, 사운드 파일은 쓰지 못하게 했습니다. 모든 형태, 표지판 글자, 소리까지 전부 코드로 생성해야 합니다.
본 과제 전에: low가 너무 잘해서 과제를 바꿨습니다
사실 이 두 과제는 처음 고른 과제가 아닙니다. 원래는 2D 서바이벌 게임과, 기관사가 되어 지하철을 운행하는 시뮬레이션을 먼저 냈습니다. 그런데 두 과제 모두 low effort에서 너무 잘 만들어서 과제를 바꿨습니다. 따로 시켜본 레이싱 게임도 low에서 부스트, 드리프트 같은 요소까지 잘 만들어줬고요.
Opus 5.5는 low effort로도 대부분의 과제를 잘 수행합니다. 그래서 아래 결과에서 볼 차이는 “되느냐 안 되느냐”보다 디테일 쪽입니다.
결과 1: 뮤직비디오는 연출의 밀도가 달라졌습니다
다섯 편 모두 뮤직비디오로서 기본은 해냈습니다. 그런데 디테일을 들여다보면 차이가 좀 있습니다. 양 끝인 low와 max를 비교해보겠습니다.
low는 지하철이 달리는 모습을 평면적인 그래픽으로 표현했습니다. “사람 파도 속에 끼여”라는 가사에서는 그냥 파도가 울렁이는 그림을 보여줬고요. 화면에 공백이 크게 잡혀 어색한 구간도 있었고, 한 장면에서는 박자가 조금 밀렸습니다.
max는 조금 더 동적이었습니다. 같은 “사람 파도” 가사에서 실제로 사람들로 이뤄진 파도를 만들었습니다. 가사를 띄우는 데서 그치지 않고 가사를 그림으로 번역한 거죠. 이런 연출은 low에서는 나오지 않았습니다. 그래픽도 평면 위주였던 low와 달리 입체적인 장면이 많았고, 가사도 박자에 맞춰 나왔습니다.
아주 디테일한 부분도 있었습니다. max는 화면 오른쪽 위에 시계를 두고, 곡이 흐르는 동안 시간이 흘러가게 만들었습니다. 출근 시간인 아침 7시에서 시작해, 퇴근 시간이 되면 시간이 쭉 넘어가며 밤 시간대로 바뀝니다. 30초짜리 곡 한 바퀴에 하루를 담은 셈입니다. 뮤직비디오에서 effort가 바꾼 건 연출과 상상력의 밀도였다고 봅니다.
결과 2: 강남역 탐험은 단계마다 디테일이 쌓였습니다
강남역 탐험은 다섯 단계를 하나씩 직접 걸어보며 비교했습니다. 걸으면서 확인한 것을 항목별로 정리하면 이렇습니다.
| effort | 인물 | 빛 표현 | 편의점 | 개찰구 | 열차 내부 | 눈에 띈 오류 |
|---|---|---|---|---|---|---|
| low | 원통형에 가까운 사람 | 대합실 천장 조명이 하얗게 번짐 | 확인 안 함 | 카드를 찍어야 열림 | 확인 안 함 | 개찰구 가운데 남은 이상한 물체 |
| medium | 옷을 입고 가방을 멘 사람 | 승강장 빛 번짐이 조금 덜해짐 | 직원이 있고 상품을 색깔로 구분 | 카드를 찍어야 열림, 가운데 물체 사라짐 | 확인 안 함 | 반짝이는 부분 처리가 어색함 |
| high | 옷과 가방 유지, 승강장 승객 증가 | 대합실 빛 번짐이 꽤 심함 | 상품 박스에 글자, 종류 다양 | 교통카드 찍고 통과 | 탑승 가능, 손잡이 구현 | 빛 번짐 외에는 없음 |
| xhigh | 핸드폰을 보며 걷는 사람 | 언급 없음 | 글자 없이 색깔로만 구분 | 교통카드 찍고 통과 | 승객이 손잡이 없이 허공을 잡음 | 계단 가운데가 뚫려 통과됨, 에스컬레이터 중간에 뜬 물체, 거꾸로 들어오려는 사람 |
| max | 에스컬레이터로 내려가는 사람들 | 계단의 빛 반사까지 표현 | 자동문, 상품에 그림 | 통과하면 회전하는 개찰구 | 손잡이, 서 있는 승객, 핸드폰 보는 사람, 가방 든 사람 | 승강장 노선도 일부 끊김 |
표로 보면 디테일은 단계마다 쌓였지만, 한 방향으로만 좋아지지는 않았습니다. medium부터 건물 디테일이 늘고 사람이 옷을 입었고, high에서는 밤 풍경에 음영이 생기고 델리만쥬·호두과자 가게까지 들어섰습니다. xhigh에서는 핸드폰 보는 사람이 새로 생겼지만 계단 구멍과 허공을 쥔 승객이 함께 나왔고, 편의점 글자는 오히려 사라졌습니다. 바깥 풍경도 개인적으로는 high가 더 자연스러웠고요. max에서는 그 계단이 막혔고, 빌딩과 전광판, 오가는 차량까지 자연스러웠으며, 대합실 안내 지도에는 현재 위치까지 표시됐습니다.
기능만 놓고 보면 차이는 작았습니다. 교통카드를 찍어야 열리는 개찰구는 다섯 단계 모두 동작했습니다. 차이는 그 위에 얹힌 디테일과 완성도에서 났습니다.
effort별 비용, 시간, 도구 호출 비교
이제 숫자를 보겠습니다. 먼저 뮤직비디오입니다.
| effort | API 환산 비용 | 소요 시간 | 도구 호출 | 서브 에이전트 |
|---|---|---|---|---|
| low | 1.45달러 | 12분 | 28회 | 0개 |
| medium | 5.02달러 | 75분 | 69회 | 0개 |
| high | 7.55달러 | 46분 | 86회 | 0개 |
| xhigh | 11.96달러 | 54분 | 125회 | 0개 |
| max | 30.35달러 | 110분 | 235회 | 0개 |
강남역 탐험은 이렇습니다.
| effort | API 환산 비용 | 소요 시간 | 도구 호출 | 서브 에이전트 |
|---|---|---|---|---|
| low | 3.95달러 | 25분 | 30회 | 0개 |
| medium | 13.11달러 | 61분 | 100회 | 0개 |
| high | 16.72달러 | 88분 | 115회 | 0개 |
| xhigh | 29.59달러 | 171분(2회 나눠 실행) | 153회 | 0개 |
| max | 101.06달러 | 173분(2회 나눠 실행) | 571회 | 2개 |
예상대로 effort를 올릴수록 비용이 늘었습니다. low와 max를 비교하면 뮤직비디오는 21배, 강남역 탐험은 26배 차이입니다. 두 과제 열 번을 합친 API 환산 비용은 220.75달러였고(단계별 금액은 반올림 값이라 표 합계와 1센트 차이가 납니다), 그중 강남역 max 한 번이 101.06달러로 절반 가까이를 차지합니다.
도구 호출 수도 두 과제 모두 effort 순서대로 늘었습니다. 반면 시간은 비용만큼 일관되지 않았습니다. 뮤직비디오는 medium(75분)이 high(46분)보다 오래 걸렸고, 강남역은 순서대로 늘었지만 xhigh와 max는 두 번에 나눠 실행해서 연속으로 잰 시간이 아닙니다. 그래서 시간은 참고용으로만 보고, 비교 기준은 비용으로 두는 게 맞다고 봅니다.
max만 일하는 방식이 달랐습니다
과정에서도 max만 달랐습니다. 강남역 탐험에서 max의 도구 호출은 571회로 xhigh(153회)의 약 3.7배였습니다. 나머지 네 단계는 서브 에이전트를 한 번도 부르지 않았는데, max만 서브 에이전트 두 개를 띄워 작업했고요. 같은 구간에서 비용도 29.59달러에서 101.06달러로 약 3.4배 뛰었습니다.
뮤직비디오 max는 서브 에이전트 없이 도구 호출만 125회에서 235회로 약 1.9배 늘었습니다. 그러니 서브 에이전트를 띄운 max는 강남역에서만 본 모습입니다. 그래도 같은 프롬프트에서 접근 방식 자체가 달라질 수 있다는 건 분명히 보였죠. effort가 높을수록 도구 호출이 많아질 수 있다는 공식 문서 설명과도 맞아떨어집니다.
GPT-6 Astra 블라인드 평가 결과
제 눈에도 max가 가장 좋았지만, 이건 어떤 결과물이 어떤 effort인지 알고 본 개인 평가입니다. 그래서 조금 더 객관적으로 보려고, 경쟁사 모델인 GPT-6 Astra에게 effort를 가린 채 블라인드 평가를 맡겼습니다. 결과물 다섯 개를 A부터 E까지 알파벳으로만 구분하고, 5개 항목을 항목당 5점씩 25점 만점으로 매기는 방식입니다.
| effort | 뮤직비디오 점수 (순위) | 강남역 점수 (순위) |
|---|---|---|
| low | 16 (5위) | 17 (5위) |
| medium | 20 (3위) | 19 (4위) |
| high | 22 (2위) | 21 (3위) |
| xhigh | 19 (4위) | 22 (2위) |
| max | 24 (1위) | 24 (1위) |
Astra는 블라인드 평가에서도 두 과제 모두 max를 1위, low를 5위로 꼽았습니다.
강남역 탐험은 순위가 effort 순서와 완전히 같았습니다. max, xhigh, high, medium, low 순이죠. 적어도 이 과제에서는 비싼 설정일수록 평가도 높았습니다. 뮤직비디오는 가운데가 뒤집혔습니다. max 1위, high 2위, medium 3위까지는 자연스러운데, xhigh가 medium보다 아래인 4위로 내려갔습니다.
Astra가 남긴 메모를 보면 판단 근거가 더 분명해집니다. 뮤직비디오 low는 장면이 길게 이어져 의미별 연출과 움직임 변화가 상대적으로 적다고 했고, max는 가장 풍부한 시각 변화와 일관된 색 체계, 읽기 좋은 주요 가사가 강점이라고 했습니다. 강남역 low는 과한 실내 빛 번짐, 단순한 인물·거리 표현, 반복되는 오디오 필터 보정 경고가 아쉽다고 했고요. max는 거리, 상점, 광고, 안내도, 승객의 밀도와 재질이 가장 설득력 있다면서도, 계단 천장 경계에 지상 구조물이 비쳐 보이는 틈은 아쉽다고 짚었습니다.
강남역을 직접 걸어보며 느낀 차이와 Astra의 지적도 꽤 겹칩니다. low의 빛 번짐, max의 디테일 밀도가 대표적입니다.
비용 대비 품질: 비용이 뛰는 구간과 가성비 경계
품질과 비용을 같이 놓으면 두 가지가 보입니다. 비용이 가장 크게 뛰는 구간은 xhigh에서 max이고, 점수 1점당 비용이 달라지는 경계는 high입니다. 서로 다른 얘기라 나눠서 보겠습니다.
비용은 xhigh에서 max로 갈 때 가장 크게 뜁니다
금액으로 보면 low에서 xhigh까지는 완만하게 오릅니다. 뮤직비디오는 1.45달러에서 11.96달러, 강남역은 3.95달러에서 29.59달러입니다. 그런데 xhigh에서 max로 넘어가는 한 단계에서만 뮤직비디오는 18.39달러, 강남역은 71.47달러가 늘었습니다. 증가 금액으로는 두 과제 모두 이 구간이 가장 컸습니다.
점수 1점당 비용은 high를 경계로 달라집니다
점수까지 같이 놓고 구간을 나눠보면 이렇습니다. xhigh는 뮤직비디오에서 high보다 점수가 낮아 기준점으로 쓰기 어려워서, high에서 나눴습니다.
| 과제 | 구간 | 점수 변화 | 비용 변화 | 1점당 비용 |
|---|---|---|---|---|
| 뮤직비디오 | low → high | +6점 | +6.10달러 | 1.02달러 |
| 뮤직비디오 | high → max | +2점 | +22.80달러 | 11.40달러 |
| 강남역 탐험 | low → high | +4점 | +12.77달러 | 3.19달러 |
| 강남역 탐험 | high → max | +3점 | +84.34달러 | 28.11달러 |
강남역은 점수 상승폭이 4점과 3점으로 비슷했지만, 비용은 12.77달러와 84.34달러로 6.6배 차이가 났습니다. 뮤직비디오는 상승폭부터 6점과 2점으로 벌어졌고요. 두 과제에 공통으로 맞는 건 “점수가 얼마나 올랐나”가 아니라 “1점에 얼마를 냈나”입니다.
점수 1점을 더 얻는 비용이 high를 넘어서면 뮤직비디오는 약 11배, 강남역은 약 9배 비싸졌습니다. 제가 high를 가성비 단계로 보는 이유입니다.
Claude Opus 5.5 effort 선택 기준
실험 결과를 바탕으로 제 기준을 정리하면 이렇습니다.
| effort | 이럴 때 | 근거 |
|---|---|---|
| low, medium | 기능만 제대로 돌아가면 될 때 | 시험 과제 두 개를 low가 이미 잘 만들었고, 교통카드 개찰구는 다섯 단계 모두 동작했습니다 |
| high | 품질과 비용을 같이 챙기고 싶을 때 | low에서 high까지의 1점당 비용이 high 이후 구간보다 훨씬 낮았습니다 |
| max | 결과물 품질이 곧 성과일 때 | 비용은 high의 4배에서 6배였고, 강남역에서는 서브 에이전트까지 띄웠습니다 |
| xhigh | 애매함 (high나 max를 권장) | 강남역 2위, 뮤직비디오 4위로 과제마다 들쭉날쭉했습니다 |
저라면 xhigh에 어중간하게 비용을 쓰기보다, 품질을 확 끌어올려야 할 때는 비용을 감수하고 max를, 가성비를 챙길 때는 high를 쓰겠습니다.
작업 성격에 따라 모델을 나눠 쓰는 기준은 GPT-5.6 Sol vs Claude Fable 5 작업별 선택 가이드에서도 정리했는데요. effort도 결국 같은 이야기입니다. 하나의 정답이 아니라 작업마다 맞는 단계가 따로 있습니다.
xhigh가 애매했던 이유
high에서 xhigh로 올리면 뮤직비디오는 4.41달러를 더 쓰고 점수가 3점 내려갔고, 강남역은 12.87달러를 더 써서 1점 올랐습니다. 돈을 더 냈는데 결과는 과제마다 반대로 나온 거죠. 공식 문서는 xhigh를 30분 넘게 도는 장시간 에이전트·코딩 작업용으로 설명합니다. 이번 xhigh 실행도 54분, 171분(두 번에 나눠 실행)이 걸려 작업 시간만 보면 그 쓰임에 가까웠지만, 결과는 과제마다 일관되지 않았습니다.
max를 쓸 때 알아둘 점
max는 결과물의 품질이 곧 돈인 일에 맞습니다. 구독으로 쓰신다면 비용 말고 하나 더 볼 게 있습니다. 바로 사용 한도입니다. 강남역 탐험의 xhigh와 max 실행은 Claude Max 구독 사용 한도에 걸려 한 번 멈췄고, 한도가 초기화된 뒤 이어서 끝냈습니다. “토큰 무제한처럼 쓴다”는 평판이 있어도, 긴 작업을 xhigh 이상으로 돌리면 구독 한도를 만날 수 있다는 얘기죠.
Opus 5.5 effort 레벨 확인과 설정 방법
단계를 고르기 전에 지금 어느 단계로 돌고 있는지부터 확인해야 합니다. 쓰는 환경에 따라 방법이 다릅니다.
API: output_config.effort
API에서는 요청의 output_config.effort에 단계 이름을 넣습니다. 공식 effort 문서의 예시는 이렇습니다.
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 4096,
    "messages": [{
      "role": "user",
      "content": "Analyze the trade-offs between microservices and monolithic architectures"
    }],
    "output_config": {
      "effort": "medium"
    }
  }'
높은 단계를 쓸 때는 max_tokens를 넉넉히 잡으라고 문서가 권하는데, 생각과 답변을 합친 전체 출력의 상한이기 때문입니다.
Claude Code: /effort
Claude Code는 세션 헤더의 모델 이름 옆에 현재 단계를 “with low effort”처럼 보여줍니다. 바꾸는 방법은 이렇습니다.
/effort                 # 슬라이더를 열어 단계 선택
/effort high            # 단계를 바로 지정하고 이후 세션 기본값으로 저장
claude --effort xhigh   # 이번 세션에만 적용해서 실행
Opus 5에서 넘어오셨다면 하나 더 확인하세요. 사용자 설정 파일의 최상위 effortLevel 값은 Opus 5.5에는 적용되지 않아서, Opus 5.5에서 쓸 단계는 /effort나 /model에서 다시 골라야 합니다. max는 환경 변수 CLAUDE_CODE_EFFORT_LEVEL로 지정하지 않는 한 현재 세션에만 적용됩니다.
이 결과를 읽을 때 주의할 점
이번 결과는 참고용으로 봐주시면 좋겠습니다.
- 자체 벤치입니다. 제가 고른 과제 두 개로 측정했습니다. 다른 종류의 작업에서는 전혀 다른 결과가 나올 수 있습니다.
- 단계마다 한 번씩만 돌렸습니다. 반복 측정을 하지 않았기 때문에, 같은 설정으로 다시 돌리면 순위가 바뀔 수 있습니다.
- 평가자는 하나입니다. 블라인드 평가는 GPT-6 Astra 한 모델의 판단이고, 제 평가는 effort를 알고 본 개인 소감입니다.
- 비용은 API 환산 비용이라 실제 청구액이 아닙니다.
- 강남역 xhigh와 max는 연속 실행이 아닙니다. Claude Max 구독 사용 한도에 걸려 두 번에 나눠 실행했습니다.
Anthropic 공식 문서도 effort의 효과는 작업 유형마다 다르니, 배포 전에 내 사용 사례로 평가해보라고 권합니다. 같은 과제로 여러 모델을 나란히 비교한 사례는 Kimi K3, Claude Fable 5, GPT-5.6 Sol 비교에도 정리해뒀습니다.
마무리
effort는 한 번 정해두고 잊는 설정이 아니라, 작업마다 다시 고르는 값에 가깝습니다. Opus 5 시절 high로 쓰던 작업을 그대로 옮겨왔다면 지금은 한 단계 낮은 medium으로 돌고 있을 수 있으니, API 요청의 output_config.effort나 Claude Code 세션 헤더에서 지금 단계부터 확인해보세요.
그다음은 직접 재보는 겁니다. 순서는 이렇게 잡으면 됩니다.
- 내 작업에서 자주 하는 과제 하나를 정합니다.
- 같은 프롬프트로 low부터 max까지 다섯 단계를 매번 새 세션에서 한 번씩 돌립니다.
- 결과물을 A부터 E까지 이름만 붙여 effort를 가린 채 비교하고 점수를 매깁니다.
- API 환산 비용과 점수를 나란히 놓고, 1점당 비용이 확 뛰는 단계를 찾습니다.
제 실험에서는 그 경계가 high였습니다. 여러분 작업에서는 어디서 갈리는지, 한 번 재보시면 좋겠습니다.
자주 묻는 질문
Claude Opus 5.5 effort별 비용은 얼마나 차이 나나요?
단계별로 한 번씩 돌린 API 환산 비용 기준으로 뮤직비디오는 low 1.45달러에서 max 30.35달러, 강남역 탐험은 low 3.95달러에서 max 101.06달러였습니다. 증가 금액은 xhigh에서 max로 넘어갈 때 가장 컸습니다.
Claude Opus 5.5의 기본 effort는 무엇인가요?
medium입니다. API와 Claude Code 모두 effort를 따로 정하지 않으면 medium으로 실행됩니다. Opus 5와 이전 Opus 모델은 high가 기본이라, 지정하지 않으면 Opus 5 때보다 한 단계 낮게 돕니다.
Claude Opus 5.5는 low effort로도 쓸 만한가요?
기능 구현만 보면 충분했습니다. 처음 낸 2D 서바이벌 게임과 지하철 기관사 시뮬레이션을 low가 너무 잘 만들어서 과제를 바꿨고, 따로 시켜본 레이싱 게임도 low에서 부스트와 드리프트까지 잘 만들었습니다. 차이는 기능보다 디테일에서 났습니다.
Claude Max 구독에서 max effort를 쓰면 사용 한도에 걸리나요?
긴 작업이면 걸릴 수 있습니다. 강남역 탐험에서는 xhigh와 max 실행이 Claude Max 구독 사용 한도에 걸려 한 번 멈췄고, 한도가 초기화된 뒤 이어서 끝냈습니다. 이때 max의 API 환산 비용은 101.06달러로 high의 약 6배였습니다.
출처
이 글이 도움이 됐나요?
좋았다면 링크를 공유하거나 반응을 남겨주세요. 남겨주신 반응은 다음 글을 개선하는 데 참고하겠습니다.